Это старая версия Информатика/Архив/2017/11Б1/matplotlib за 28.12.2016 18:15 под редакцией SergeyShashkov.
matplotlib
matplotlib
Основным материалом будет следующий ресурс: http://nbviewer.jupyter.org/gi[...]_python/tree/master/
Задача 1
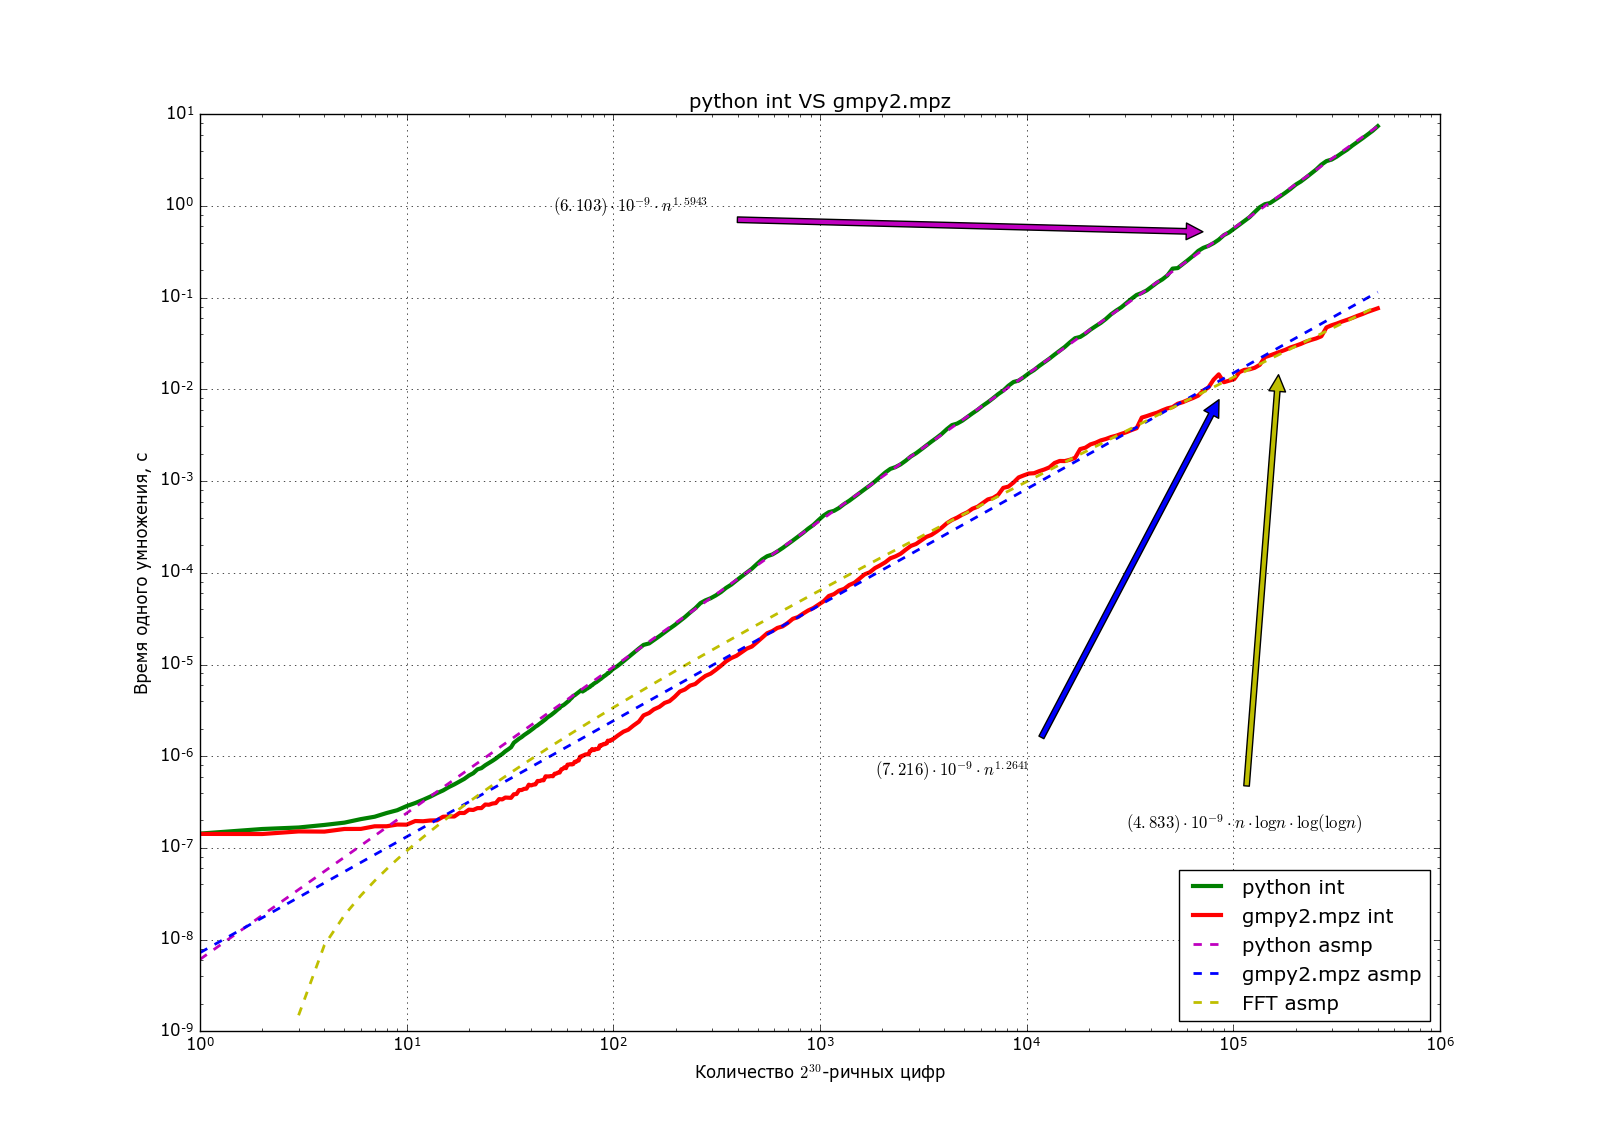
Глобальная задача: увидеть, что в питоне для умножения больших чисел используется алгоритм Карацубы, а также получить практически его асимптотику.Должен получиться график в духе такого:
Задача 2
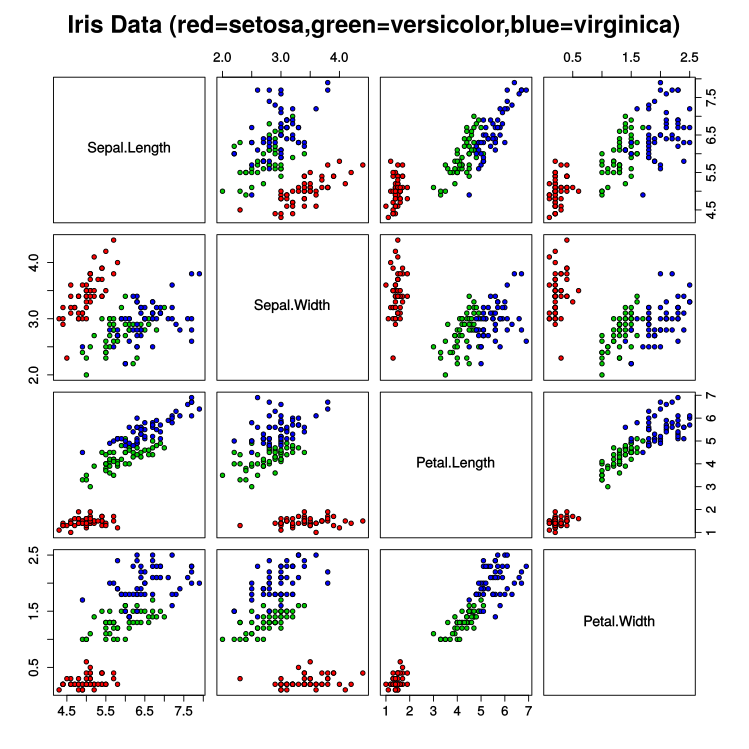
Ирисы Фишераfrom sklearn import datasets
# После этой команды будет загружен словарь (выполнить один раз)
iris = datasets.load_iris()
# Сохраняем данные на компьютер (выполнить один раз)
# data, target, feature_names, target_names = iris['data'], iris['target'], iris['feature_names'], iris['target_names']
# with open(r'M:\np_basic\iris.dump', 'wb') as f:
# pickle.dump((data, target, feature_names, target_names), f)
# Загрузка данных из сохранённого дампа
with open(r'M:\np_basic\iris.dump', 'rb') as f:
(data, target, feature_names, target_names) = pickle.load(f)
Задача 3
Титаник
Данные:
file:/titanic_train.csv
import numpy as npimport pandas as pdtitanic_df = pd.read_csv(«titanic_train.csv»)# Вектор ответовy_train = titanic_df['Survived'].as_matrix()# Удаляем ненужные столбцыtitanic_df.drop(['PassengerId','Name','Ticket','Survived'], axis=1, inplace=True)# Данныеcolumns = titanic_df.columnsx_train = titanic_df.as_matrix()Описание столбцов:
- PassengerId — идентификатор пассажира
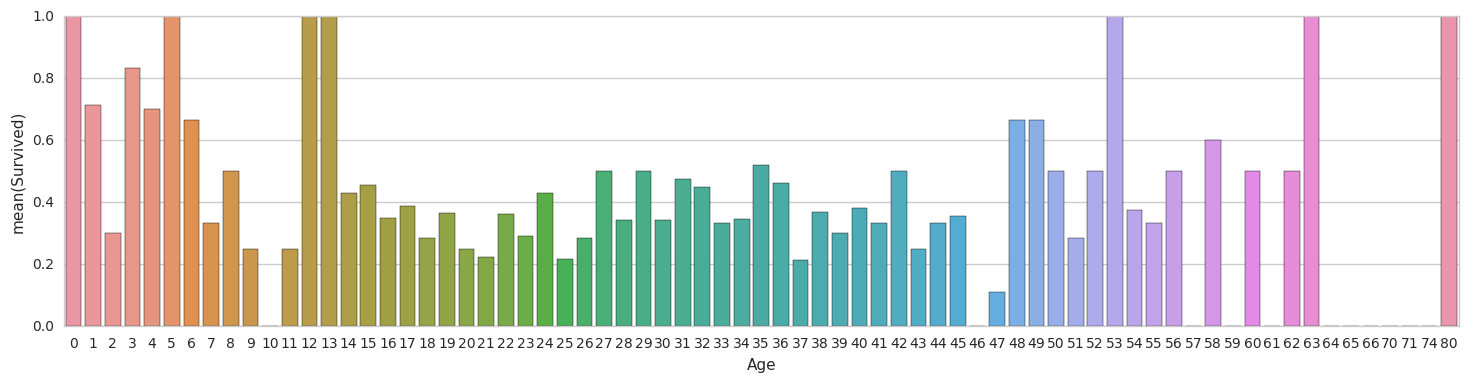
- Survival — поле в котором указано спасся человек (1) или нет (0)
- Pclass — содержит социально-экономический статус:
- высокий
- средний
- низкий
- Name — имя пассажира
- Sex — пол пассажира
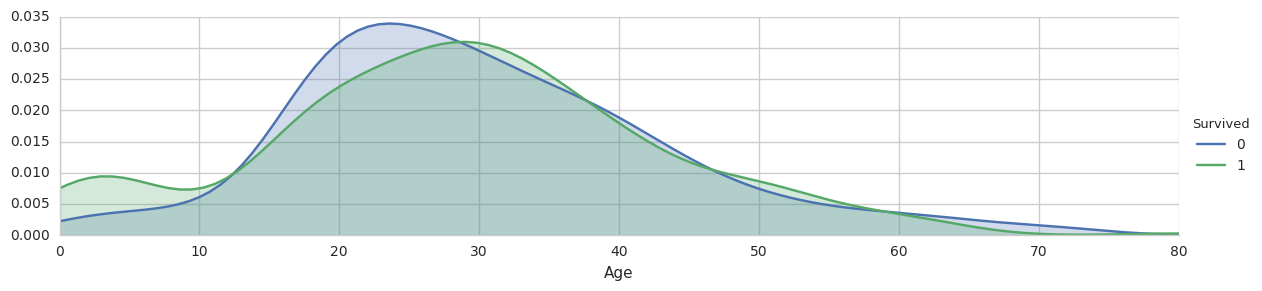
- Age — возраст
- SibSp — содержит информацию о количестве родственников 2-го порядка (муж, жена, братья, сетры)
- Parch — содержит информацию о количестве родственников на борту 1-го порядка (мать, отец, дети)
- Ticket — номер билета
- Fare — цена билета
- Cabin — каюта
- Embarked — порт посадки
- C — Cherbourg
- Q — Queenstown
- S — Southampton
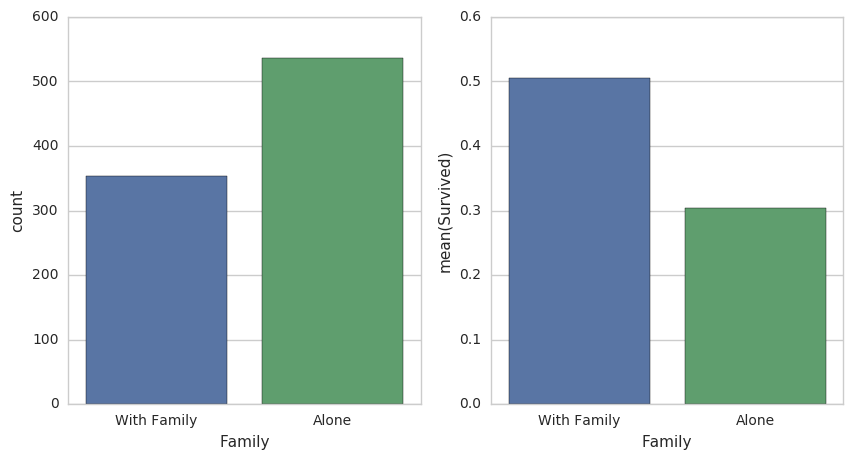
Для kaggle:
file:/titanic_test.csv
test_df = pd.read_csv(«train.csv»)# Сохраняем ID пассажировPassengerIds = test_df['PassengerId'].as_matrix()# Удаляем ненужные столбцыtest_df.drop(['PassengerId','Name','Ticket','Survived'], axis=1, inplace=True)# Делаем предсказаниеy_pred = np.zeros_like(PassengerIds)# Генерим ответsubmission = pd.DataFrame({"PassengerId": PassengerIds, «Survived»: y_pred})submission.to_csv('titanic_submission.csv', index=False)